
Кейс
Крупный сбой: от сигнала мониторинга до ответа всем заявителям
Вечером три сервера в московском офисе одновременно перестают отвечать: 1С, файловый сервер и портал заказов. Через минуту сотрудники начинают писать в поддержку. В INFRAX инциденты мониторинга попадают в сервис-деск (ITSM) и собираются в одну проблему, обращения по сбою добавляются в её состав, а закрывается она одним действием — с ответом всем заявителям.
С чего начинается
Ситуация
Что происходит
Когда падает подсеть, мониторинг открывает инцидент по каждому узлу, а сотрудники пишут о том же своими словами: «не открывается 1С», «нет общего диска», «портал заказов не грузится». За десять минут в очереди — дюжина карточек об одном и том же.
Если мониторинг и сервис-деск — разные системы, связывать инциденты с обращениями приходится вручную, отвечать — каждому заявителю отдельно, а после восстановления — обходить всех и закрывать карточки по одной.
Как это устроено в INFRAX
Мониторинг и сервис-деск — одна очередь. Алгоритм замечает, что несколько узлов одной сети перестали отвечать почти одновременно, и создаёт проблему с объяснением, а обращения по сбою добавляются в её состав.
Инженер проверяет сервер из того же продукта, а когда причина устранена, закрывает проблему одним окном: заявители получают одно сообщение, инциденты закрываются вместе с проблемой.
По шагам
Как это решается в INFRAX
Каждый шаг — экран демонстрационного стенда INFRAX 2.0: под ним подпись, что именно видно и чьими глазами. Компания «Северный склад» и все данные вымышленные.
- Шаг 01Мониторинг
Узлы перестают отвечать
Агенты трёх серверов перестают присылать данные, проверки доступности фиксируют недоступность. По каждому узлу открывается инцидент — в той же очереди, где работает поддержка.

Диск /mnt/logs сервера msk-files-01 за час глазами инженера: разрыв графика 20:47–20:56 — время сбоя; порог 45 %, предел 90 %. - Шаг 02Сервис-деск ITSM
Очередь не тонет в одинаковых карточках
Алгоритм одновременной недоступности узлов одной сети собирает инциденты в проблему, и очередь сворачивает её состав под одну полосу. Первая линия видит, сколько тикетов относится к сбою и сколько узлов затронуто.

Очередь первой линии во время сбоя: «12 тикетов свёрнуто» под проблему #46 «Недоступны узлы сети 172.30.3.0/24». - Шаг 03Сервис-деск
Обращения сотрудников — в тот же состав
Обращения по тому же сбою оператор добавляет в состав проблемы. Если проблему опубликовать, сотрудники увидят её прямо в форме нового обращения и смогут отнести к ней свой случай. Каждое обращение сохраняет своего исполнителя, сроки реакции и решения (SLA) и переписку.

Проблема #46, вкладка «Связанные тикеты»: три инцидента «Узел … недоступен» и обращения сотрудников про 1С, общий диск и портал заказов. - Шаг 04Сервис-деск
Инженер проверяет состав и ставит диагноз
В карточке написано, почему система предложила такой состав, и показана хронология его пополнения. Диагноз остаётся за инженером: состав можно подтвердить, пополнить, сузить или отклонить, а на вкладке «Узлы сети» видно, какие узлы затронуты.

Проблема #46 глазами инженера: подтверждённый состав из 12 связей — 6 инцидентов и 6 обращений, системное описание и хронология. - Шаг 05Удалённый доступ с записью PAM
Инженер подключается к серверу
Из дерева узлов или прямо из карточки инцидента инженер открывает в браузере подключение к msk-files-01 по протоколу удалённого доступа SSH и проверяет, когда сервер выключался и поднялась ли служба агента. Сеанс записывается: в журнале останутся команды по времени.

SSH-сеанс Павла Орлова к msk-files-01 из браузера: сервер был выключен 9 минут, служба агента снова работает, диски на месте. - Шаг 06Сервис-деск
Проблема закрывается одним действием
Перед завершением видно, сколько обращений получат ответ, какие инциденты закроются и что будет с каждым связанным тикетом. Заявителям уходит одно сообщение, и обращения ждут подтверждения срок из настроек SLA (по умолчанию 7 дней) — молчание завершает обращение само.

Окно «Завершить Проблему»: 6 обращений получат ответ, 3 открытых инцидента закроются, готовое сообщение заявителям и список 12 связанных тикетов. - Шаг 07Аналитика и отчётность BI
Сроки — на дашборде
В аналитике (BI) дашборд «Мониторинг» показывает статус узлов, бизнес-сервисы и активные проблемы со сроком решения, дашборд «Поддержка» — сроки по обращениям. Данные те же, что в очереди, — выгружать и сверять ничего не нужно.

Дашборд «Мониторинг» во время сбоя: красный сектор «Офлайн» в статусе узлов, проблема #46 со сроком «Просрочено: 5 ч».
Результат
Что получает ИТ-служба
Одна карточка вместо дюжины
Инциденты и обращения по одному сбою лежат в одной проблеме, а очередь остаётся рабочей.
Объяснимое объединение
Пять алгоритмов с системным описанием, почему события объединены; состав и диагноз — за инженером.
Обращения не теряют своё
У каждого обращения в составе остаются свой исполнитель, срок и переписка.
Один ответ всем заявителям
Сообщение уходит всем подходящим заявителям сразу, инциденты закрываются вместе с проблемой.
Проверка сервера — тут же
Подключение из браузера с записью сеанса, без отдельной системы контроля привилегированного доступа (PAM).
Отчёт без выгрузок
Статус узлов, проблемы и сроки — на готовых дашбордах по тем же данным.
В одном продукте
Задачи, которые здесь работают вместе
Ни одну из них не нужно покупать и подключать отдельно: пользователи, права, узлы и заявки у них общие.
Мониторинг
Агенты, SNMP v1–v3, пороги, бизнес-сервисы
Страница задачиПоддержка пользователейСервис-деск ITSM
Обращения, инциденты, проблемы, сроки SLA по календарю
Страница задачиДоступ и безопасностьУдалённый доступ с записью PAM
Подключения RDP, SSH, VNC через шлюз; запись сеансов
Страница задачиКонтрольАналитика и отчётность BI
Готовые дашборды, внешние базы, выгрузка в PDF
Страница задачиВопросы и документация
Вопросы
Система сама определяет причину сбоя?
Нет. Алгоритм находит события, совпавшие по объекту, сети и времени, и создаёт проблему в состоянии «Новая» с объяснением, какие признаки совпали. Причину подтверждает инженер — по данным мониторинга, изменениям конфигурации и результатам проверки.
Закроются ли инциденты сами, когда узлы поднимутся?
Инцидент без исполнителя закрывается сам, когда срабатывает условие восстановления и для правила включено автозакрытие. Инцидент с назначенным исполнителем закрывает человек: в него приходит сообщение о восстановлении с пояснением, почему он не закрыт автоматически.
Что увидит сотрудник, который пишет о сбое после публикации проблемы?
Опубликованная проблема показывается в форме создания обращения, и сотрудник может указать, что его случай относится к ней. Для пользователей пишется отдельное описание — проявление сбоя, затронутая услуга и ожидаемый срок, без внутренних имён узлов и адресов.
Кейсы
Другие кейсы
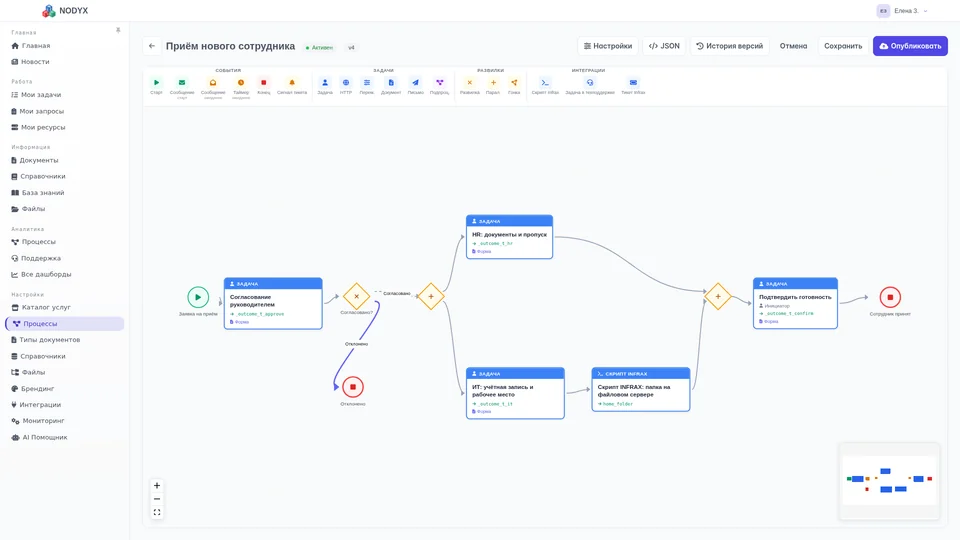
Новый сотрудник: одна заявка вместо писем в три отдела
Выход сотрудника оформляют одной заявкой на портале. HR, ИТ и скрипт на файловом сервере отрабатывают свои шаги, а учётная запись и ноутбук появляются в одном продукте.
Портал и процессы ESM · BPMАвтоматизация и бэкапСервис-деск ITSMВход и права IAM · SSOУчёт активов CMDB · ITAMРазобрать по шагам
Подрядчик на две недели: доступ по заявке и с записью сеансов
Подрядчик меняет коммутатор на складе. Работы ведутся в заявке, схема сети открыта ему на две недели, сеансы пишутся, а после работ доступ снимается одним действием.
Вход и права IAM · SSOУдалённый доступ с записью PAMСервис-деск ITSMЗнания и файлы KBРазобрать по шагам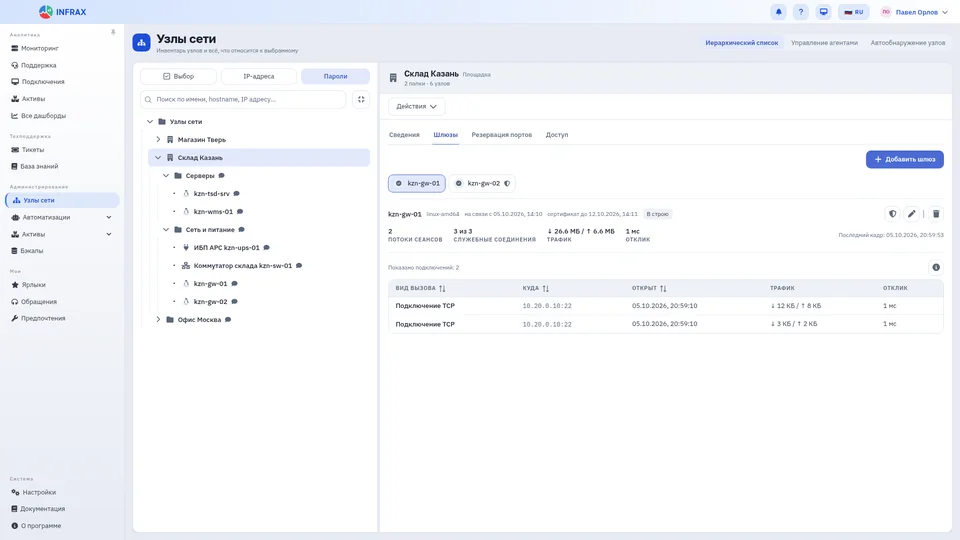
Новый филиал без VPN: площадка подключается одним кодом
На складе в Казани ставят небольшой сервер со шлюзом площадки. Мониторинг, опрос устройств по SNMP и подключения к серверам идут через него, без VPN и открытых портов.
ФилиалыМониторингУдалённый доступ с записью PAMРазобрать по шагам